

 新聞
 幣種資訊
 關於我們


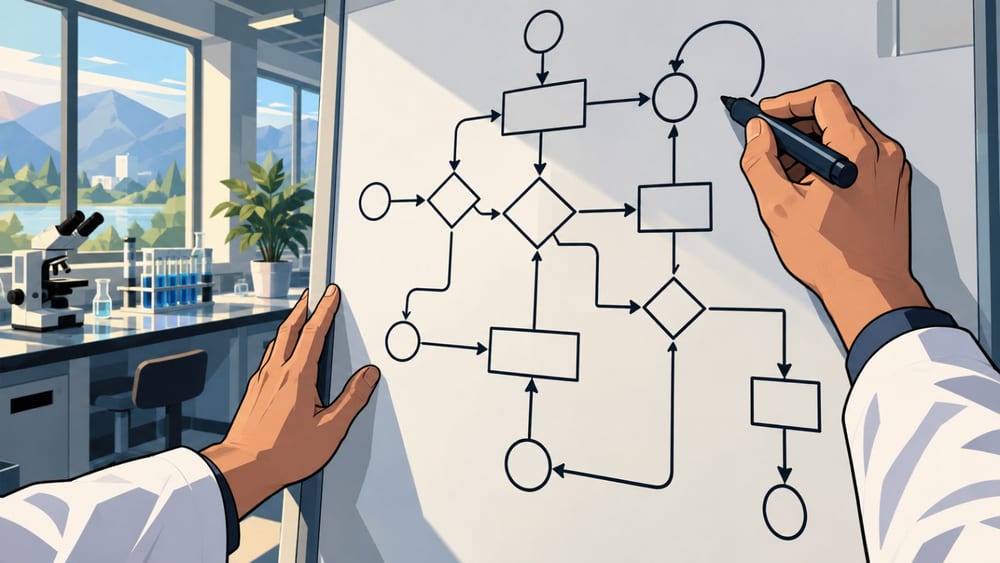
將大型語言模型(LLM)代理人的工作流程結構化為圖表,可能提升長期任務表現。一項研究評估7個基準測試與4個LLM後發現,在24組模型與基準測試組合中,21組取得最佳或並列最佳成績。
Yuxing Lu、Yicheng Chen、Shanchan Wu與Sercan Ö. Arık研究團隊於9月8日公開在arXiv的論文中,提出「程序圖(Procedural Graphs):面向LLM代理人的自我演化執行架構」。論文由Google研究人員與學術研究者共同參與,但目前未公布Google的獨立官方聲明或商業化時程。
結構化程序知識
程序圖像知識圖譜以「實體—關係—實體」形式儲存事實一樣,以「程序—關係—程序」形式呈現工作順序與條件。節點代表工具呼叫、推理步驟與任務狀態,連線則記錄轉換條件、執行指引及應避免的錯誤。
代理人在執行任務時,會先在圖中定位目前位置,再將周邊兩層範圍的結構傳給指引模型。指引模型會把這些資訊轉換成符合當前情境的指引,提供給求解器,但不會強制決定最終行動。研究團隊表示,這種設計希望同時保留自由推理與程序控制。
圖表會根據執行結果自行調整。以LLM為基礎的精煉器會比較成功與失敗的任務,提出節點及連線的修改方案,只有在獨立驗證集上維持或提升表現時才會採用。未被採用的方案則會留下負面紀錄,避免重複提出相同修改。
這項方法也呼應AI代理人競爭從模型效能轉向企業系統的趨勢。其核心不是重新訓練模型,而是整理外部執行架構,試圖降低長期任務中的錯誤。
24組組合中21組取得最佳或並列最佳
研究團隊評估HotpotQA、MultiChallenge、GDPval、ALFWorld、τ-bench、BFCL v3與EnterpriseArena等7個基準測試,以及Claude Sonnet 4.6、Gemini 3.1 Pro、Gemini 3.5 Flash與Grok 4.1 Fast等4個LLM。
程序圖在24組模型與基準測試組合中,有21組取得最佳或並列最佳表現。不過,各項任務的改善幅度並不一致,部分問答任務的差距有限。
在評估長期任務的EnterpriseArena中,Gemini 3.1 Pro的整體存活率由既有方法的6%升至採用程序圖後的34%,提高28個百分點。EnterpriseArena是一項模擬代理人長期執行企業財務決策的測試,資金籌措要經過1至6個月才會反映,且代理人必須應對多次經濟危機。
在這個環境中,結果不只取決於回答單一問題的能力,也受到長期維持先前決策與任務條件能力的影響。程序圖會將先前階段的程序與條件結構化,讓代理人在選擇下一步行動時參考。
在自我演化實驗中,驗證集存活率由0%升至90%,最終返回圖表的測試存活率為85%。研究團隊也明確指出,實驗以各分割20個情節為基礎,個別修改是否被採用,可能受到一至兩個情節影響。
目前公開的反應主要來自獨立研究筆記與論文摘要。有意見認為,程序圖比單純的對話紀錄或文字記憶更容易檢查下一步行動;但也有批評指出,僅靠驗證集進行自動採用,無法保證圖表中的條件在真實環境中同樣正確。
截至目前,Google正式導入產品、企業客戶採用及相關服務推出的消息均未獲確認,研究也未提出與虛擬資產或區塊鏈產業的直接連結。
這項研究是以arXiv預印本為基礎,尚非經同儕審查的學術期刊論文,也沒有獨立機構的重現結果。因此,研究結果應解讀為:結構化程序知識在特定基準測試與模型組合中可能有效。
圖表搜尋與指引生成過程需要額外推理與代幣使用。即使準確率與長期存活率提高,營運成本與延遲也可能增加;錯誤的圖表修改是否會持續累積,也仍須另行驗證。
程序圖已提出緩解LLM代理人長期執行問題的可能性,但在實際服務環境中的可重現性,以及不同行業的適用效果,仍有待進一步研究。


留言 0