

 News
 Coin Information
 About us


 Add as a preferred source on Google
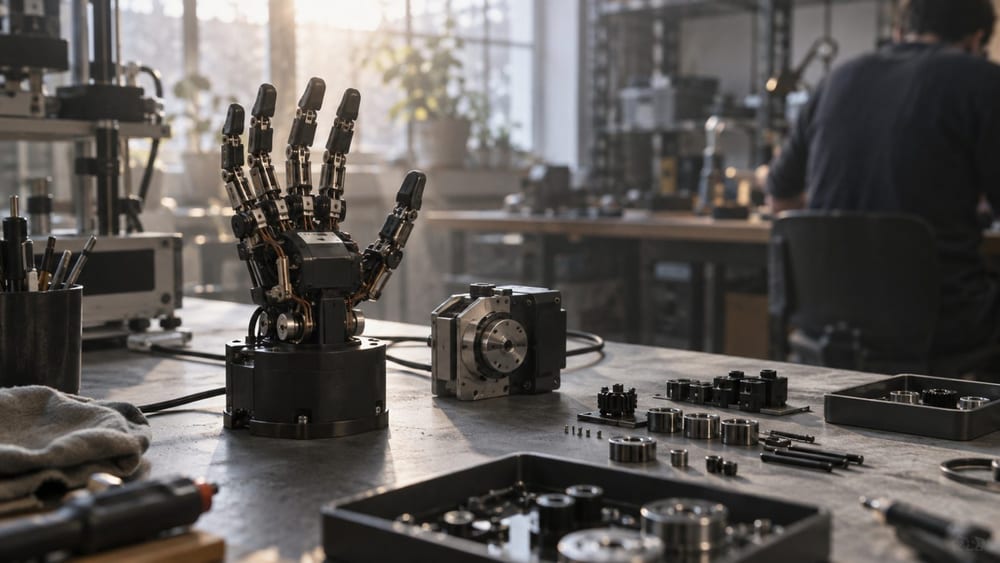
Dyna Robotics 於 9 月 29 日公布 Dyna-2.1,將長時間任務規劃與機器人動作執行分開處理。系統由視覺語言模型協調器、Dyna-2 policy,以及獨立的全身控制器組成。
Dyna Robotics 在Dyna-2.1 技術文件中說明,協調器負責決定下一步,Dyna-2 policy 產生動作目標軌跡,全身控制器則以每秒 100 次的頻率控制關節目標值與輪速。
協調器會以文字記錄任務狀態,例如洗衣機是否已啟動、已摺好的毛巾數量,再將這些資訊納入下一步判斷。這種記憶功能是用來延續任務進度;新增紀錄本身不代表動作 policy 學會了新技能。
Google DeepMind 於 7 月 30 日介紹 Gemini Robotics 2、Gemini Robotics ER 2 和 Gemini Robotics On-Device 2。依據公司公布的架構,視覺語言行動(VLA)模型會把輸入轉換為行動控制;推理模型理解物理環境並規劃多步驟任務;端側模型則在機器人裝置上執行(公告)。
Figure AI 的 Helix 將兩個層級的運作週期分開。公司在Helix 公告中表示,負責理解場景與語言的視覺語言模型每秒運作 7 至 9 次,產生連續動作的視覺運動 policy 則每秒運作 200 次。
Helix 的運作週期是該系統的設計值,並非可與 Anthropic 評估中的回應率或其他機器人系統效能直接比較的共同指標。
也有研究嘗試將語言與視覺知識、機器人動作結合在同一系列模型中。Google DeepMind 於 2023 年發布 RT-2,將以網路規模資料預訓練的視覺語言模型與機器人示範資料結合。公司表示,在超過 6,000 次機器人測試中,模型對未見過任務的泛化表現較既有基準模型提升逾 3 倍(RT-2 公告)。
Dyna Robotics 表示,Dyna-2 使用超過 100 萬小時的人類第一人稱視角影片進行預訓練。公司提出的研究顯示,隨著人類影片資料增加,另行評估的機器人資料預測表現也有所改善。
這 100 萬小時指的是人類拍攝影片的長度,不代表機器人實際運作時間,也不代表機器人示範資料的規模。
因此,在討論機器人模型是否會被大型語言模型(LLM)取代之前,必須先釐清「機器人模型」的定義。已公開的案例中,負責任務規劃的模型、產生動作的 policy,以及執行低階控制的層級會同時出現;部分研究則將知識與行動輸出結合在同一系列模型中。
低階控制的回應速度仍是另一項挑戰。Anthropic 在 7 月公布的機器人控制評估指出,四足機器人的低階控制每秒約需 83 次回應;當時非推理模型的回應速度則約為每秒 0.2 至 0.4 次。
直接控制測試採用一種方式:等待模型回應時暫停模擬器。因此,這項結果不能解讀為實際機器人的即時控制效能,也不能推廣為所有 LLM 的控制能力。
同一份評估也記錄了語言模型監督預先訓練的機器人 policy,並完成部分移動與物體操作任務的案例。模型直接控制關節的測試,與監督既有 policy 的測試條件並不相同。
將人類示範轉移至機器人 policy 的資料蒐集方式也在研究中。UMI 研究探討了人與機器人的身體差異、動作精度及推理延遲等設計問題(論文)。
讓模擬場景更逼真,與準確預測實際物理結果,是兩個不同問題。一項機器人模擬研究指出,在部分視覺導航任務中,提高模擬忠實度並未改善轉移至真實環境的表現;模擬速度較慢,以及對物理模型誤差過度擬合,都可能損害效能(研究)。這是研究團隊針對特定任務得到的結果,不能推廣至所有模擬器。
本刊先前曾報導整合 World ID 的 PeakOS 公開藥品配送機器人示範。
Dyna Robotics 將 Dyna-2.1 導入客戶場域列為下一階段工作。已公開的案例呈現了將任務規劃、動作生成與低階控制分開處理或整合的不同設計。

Comment 0