

 新聞
 幣種資訊
 關於我們


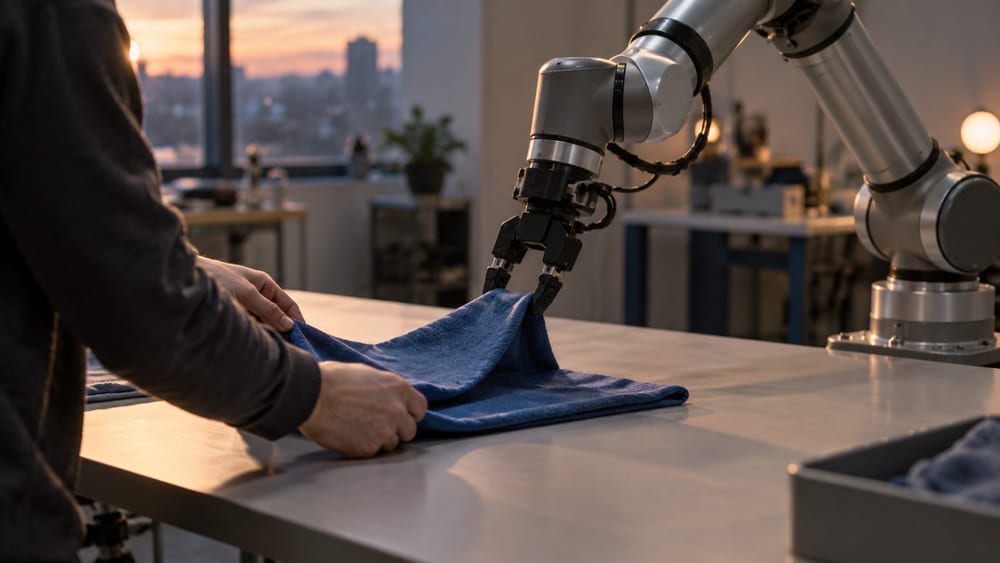
Google DeepMind 推出世界模型 Genie 4,能依照使用者指令改變場景,並生成聲音與對話。使用者在虛擬環境中移動、調整天氣或加入人物時,模型會接續呈現變化後的情境。
Crypto Briefing 報導,Google DeepMind 於 27 日宣布,開始向可信任的測試使用者提供 Genie 4 作為研究用途。該媒體指出,這項開發擴展了 Google 的人工智慧能力。世界模型能生成空間與動作,並依使用者的行為建立後續場景;在 Genie 4 中,使用者可用鍵盤控制移動方向與視角,也能透過自然語言修改周遭環境。
新功能之一是生成聲音。Crypto Briefing 報導,模型可隨影片產生環境音、音樂與人物對話。使用者介入場景時,人物也會依情境作出反應;物體碰撞、樹木隨風搖曳等動態也能呈現。
場景生成會運用 Gemini 模型。Crypto Briefing 說明,Gemini 3.8 Flash 會檢視生成中的場景,將目標拆分成多個步驟並確認進度。Google 也公開了將 Gemini 4 Aragon 與 Genie 4 結合,在虛擬環境中逐步模擬機器人作業的測試案例;不過,這項案例並未被呈現為已證明實際作業效能的結果。
Crypto Briefing 也指出,這項技術仍有局限。模擬時間拉長或使用者多次更改指令時,物體外觀與位置可能改變,也未必能完整重現真實場景。連續互動時間約為數分鐘,複雜的物理互動與聲音準確度仍是研究課題。
Genie 4 生成的影片與聲音會加入 AI 生成內容識別技術 SynthID。Crypto Briefing 報導,Google DeepMind 計畫先收集測試使用者意見,再擴大提供範圍,對象包括 Project Genie 的 Google AI Ultra 訂閱者,以及 Gemini API 和 Google AI Studio 的早期合作夥伴。擴大提供的日期尚未公布。

留言 0