

 新聞
 幣種資訊
 關於我們


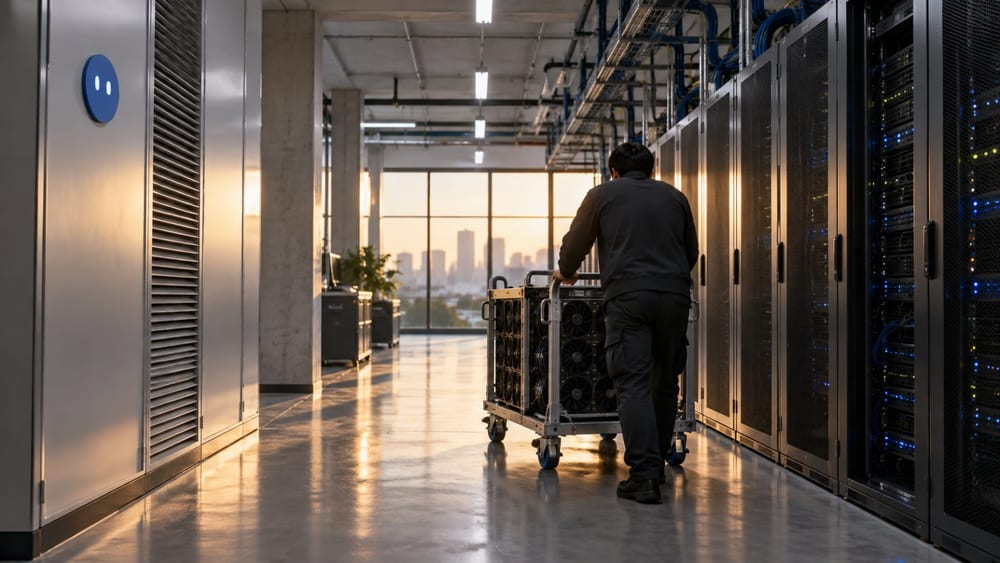
中國月之暗面(Moonshot AI)開發的大型開放權重模型Kimi K3,近期接連登上美國AI基礎設施業者的API服務。Modal採用專用推理加速器,提出每秒處理460個Token的效能。
Kimi K3是一款擁有2.8兆個參數的混合專家(Mixture-of-Experts,MoE)模型。在896個專家模組中,每個Token會啟用16個模組,啟用參數約為1040億個。其上下文視窗達104萬8576個Token,主要面向長篇文件與大型程式碼庫處理。
月之暗面隨技術報告公開Kimi K3的模型權重。這也凸顯模型開發與實際服務營運之間存在差距。
Modal於2026年7月27日宣布開始支援Kimi K3,並表示在自有環境中達到每秒處理460個Token。這項結果來自針對Kimi K3訓練的DFlash推理加速器。DFlash會先預測模型可能生成的Token,再由實際模型進行驗證,以提高處理量。
每秒460個Token是在Modal特定硬體與軟體設定下測得的數值,不能據此斷定其他GPU配置或工作環境也能重現相同速度。實際效能可能受到請求長度與並行處理量影響。
Fireworks與Baseten也將Kimi K3作為API模型提供。三家業者公布的價格相同,輸入Token每100萬個3美元(約4158韓元)、快取輸入Token每100萬個0.30美元(約416韓元)、輸出Token每100萬個15美元(約2萬79韓元)。
API服務的價格競爭顯示,僅公開模型權重並不足以建立完整的服務。企業客戶除了Token單價,也需要同時比較專用GPU費用、等待時間、快取命中率、資料傳輸費用、並行請求數量與批次處理方式。
Kimi K3的營運難度,也反映在模型規模上。若要自行部署,GPU記憶體容量以及GPU之間的連線頻寬都十分重要。
不過,公開資料尚未確認運行Kimi K3必須使用8張GB300的具體部署配置。因此,不宜將特定GPU數量視為模型運營的必要條件,而應將其區分為個別部署環境下的案例。
輝達($NVDA)將GB300 NVL72描述為由72張Blackwell Ultra GPU與36顆Grace CPU組成的機架級系統。AMD的MI355X則支援288GB HBM3E與8TB/s記憶體頻寬。
兩款產品的規格顯示,服務大型模型時,GPU的運算效能之外,記憶體容量與資料傳輸速度同樣重要。模型規模越大,將權重載入記憶體並在多張GPU之間交換資料的過程,越可能影響服務成本與延遲時間。
美國商務部產業與安全局(BIS)指出,出口管制可能適用於前往包括中國在內D:5國家的先進運算積體電路及相關設備。不過,公開資料尚未確認月之暗面無法直接取得特定美國GPU,也未確認美國服務業者全部採用這些GPU。
社群也出現其他效能案例。Reddit一名使用者聲稱,使用8張B300 GPU運行Kimi K3,達到每秒92個Token,成本約為每100萬個Token 190美元(約26萬3340韓元)。
這項實驗來自個人貼文,無法與Modal提出的每秒460個Token在相同條件下比較。服務業者自有基準測試與社群實驗,在硬體、軟體、請求配置及成本計算方式上都可能不同。
這起案例顯示,大型AI模型的競爭力不只取決於模型架構。即使公開模型權重,進入實際服務階段後,仍需要GPU記憶體、網路連線、推理軟體與資料處理政策配合。成本與速度優勢,仍需在相同模型、硬體及工作負載下,經獨立驗證後才能判斷。


留言 0