

 News
 Coin Information
 About us


 Add as a preferred source on Google
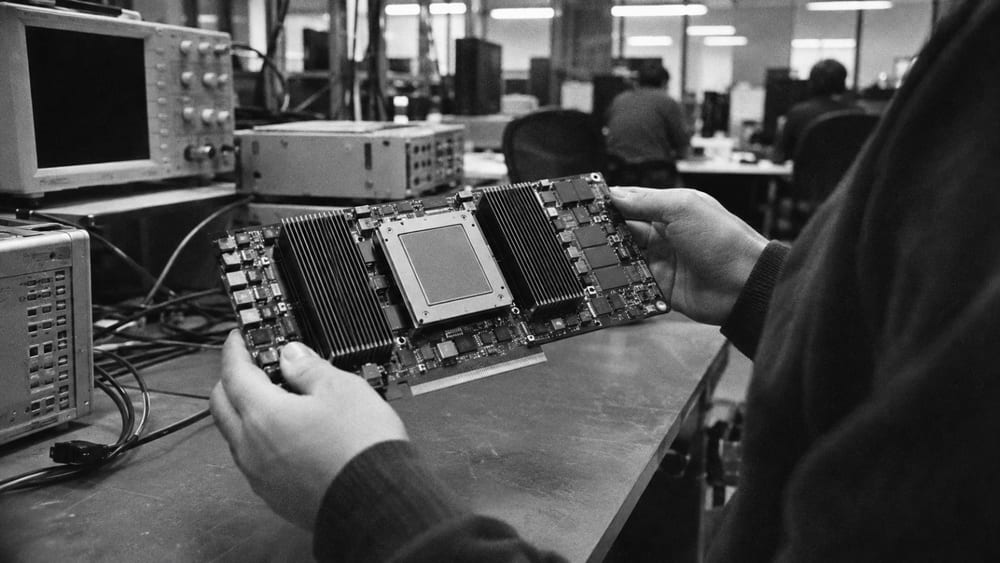
MLCommons公布MLPerf Training v6.1的250筆測試結果,涵蓋153套系統;推薦系統訓練與軟體開發用大型語言模型後訓練,首度列入評測項目。
MLCommons於台灣時間16日零時發布公告,表示共有24個機構參與本次測試。所有系統中,有57套(37%)採用雲端架構。
雲端系統占比高於前一版v6.0的29%。本次結果也納入更多加速器的大型系統,以及新增訓練任務的測試紀錄。
MLPerf Training以指定模型和資料進行訓練,測量系統達到目標品質所需的時間。各項測試使用的模型、資料與目標品質不同,因此250筆結果不宜合併解讀為單一效能排名。
基準測試規則區分Closed與Open division,也依系統是否可購買或租用分類。MLCommons指出,訓練時間會有波動,非影像類基準測試的波動幅度約為±5%。MLPerf Training說明也列出各項測試的比較條件。
推薦系統測試DLRMv4-HSTU取代原有的DLRM-dcnv2基準測試。這項測試採用依序處理使用者行為紀錄的HSTU架構,測量推薦模型的訓練時間。DLRMv4說明介紹了測試使用的資料與架構。
測試使用音樂服務的使用紀錄資料集Yambda-5B,內含約47.9億筆互動紀錄。
新增的後訓練測試,測量訓練Qwen3.5-397B-A17B執行軟體開發任務所需的時間。模型會在隔離的執行環境中嘗試完成任務,再根據結果進一步訓練。後訓練基準測試說明列出的目標品質為「0.69 pass @ 4」。
這項測試採用GRPO(Group Relative Policy Optimization)方法,比較多次嘗試的相對獎勵,再更新模型;其範圍不同於評估代理在實際服務中所有任務品質的測試。
MLCommons先前曾發布探討推論階段吞吐量與回應時間的報告。本次v6.1測量的是模型達到訓練目標所需的時間,不是推論速度。
本次提交的系統中,有12套使用超過1000個加速器,規模最大的一套使用1萬240個。輝達(NVIDIA,$NVDA)的Rubin世代GPU與Google TPUv7 Ironwood也首度出現在MLPerf Training結果中。
Google Cloud表示,使用8192個Ironwood TPU進行DeepSeek-V3預訓練任務,1.70分鐘便達到目標品質;在使用640個Ironwood的Qwen後訓練測試中,所需時間為18.02分鐘。兩項紀錄的任務與加速器數量不同。
超微(AMD,$AMD)在提交者補充資料中表示,使用8個MI350X或MI355X進行Llama訓練,效能較v6.0平均提升19%。輝達則表示,在使用相同數量GPU的條件下,Vera Rubin NVL72在部分測試中比GB300 NVL72快最多2倍。
上述數據是各公司對自家提交結果的說明。MLCommons明確表示,補充資料中的個別廠商說明不代表協會觀點。提交者補充資料收錄了各廠商的結果與說明。
官方結果儀表板提供依模型、提交機構、加速器數量及系統配置分類的紀錄。查看結果時,仍須對照相同訓練任務與系統條件。

Comment 0