

 News
 Coin Information
 About us


 Add as a preferred source on Google
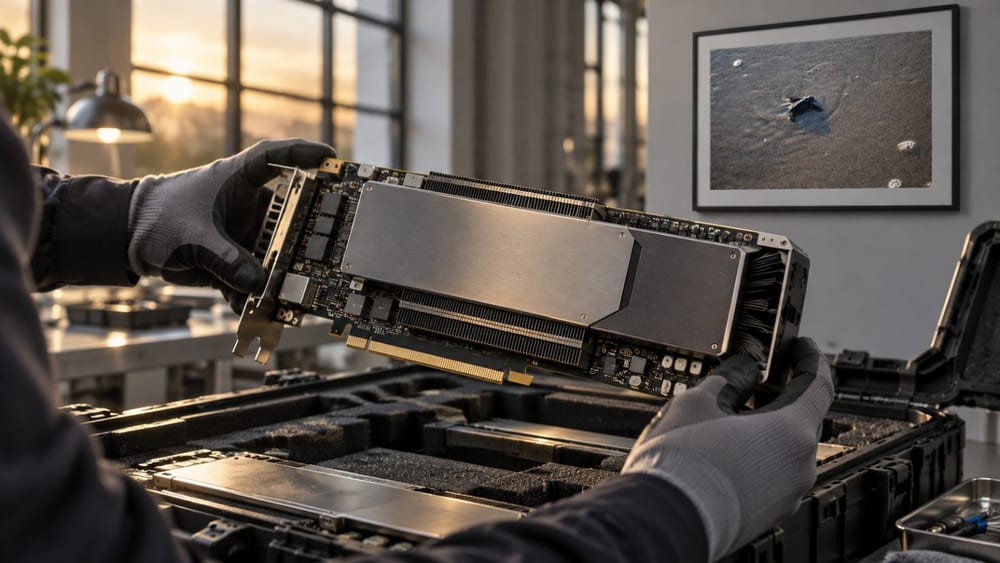
超微半導體(AMD)公布資料中心GPU Instinct MI430X的FP64最高效能預估為288 TFLOPS,並說明由4張GPU直接互連的伺服器配置。
超微於12日發布MI400系列更新,補充MI430X在科學運算與AI方面的用途和產品資訊。超微5月先行介紹這款預計推出的產品,此次再說明規格與連接架構。
超微列出的規格包括432GB HBM4記憶體、最高每秒23.3TB記憶體頻寬,以及用於AI運算的FP4最高9.2 PFLOPS。超微表示,這款產品是為大型模擬運算和AI模型工作而設計。
超微於13日確認的產品頁指出,FP64最高288 TFLOPS是上市前的工程預估,實際結果可能不同。該頁表示,此數值是根據超微效能實驗室於2026年7月所做的工程預估。超微技術部落格也說明,效能數字反映分析模型與早期晶片目標的預估。
超微於5月6日預先介紹MI430X時,曾預估FP64效能將超過200 TFLOPS。兩個數字都是上市前預估,不代表實測效能有所提升。
超微技術資料展示了以第6代EPYC伺服器處理器搭配4張MI430X的配置,並透過Infinity Fabric互連。每張GPU都直接連接另外3張GPU。
超微列出的每張GPU單向傳輸頻寬上限為每秒384GB。這項數值是以單張GPU為基準。
FP64是雙精度浮點運算,常用於科學模擬與建模等需要高計算精度的工作。超微表示,該平台可同時支援科學運算所需的FP64和AI運算功能,並提供ROCm軟體環境。
超微研究人員分析了11個應用程式與基準測試中的47種工作配置。研究使用的是既有的Instinct MI350X與MI355X,並非MI430X。
研究人員分析指出,在大型稠密矩陣乘法等少數工作中,以較低精度運算實現FP64可能有效;但多數受分析的科學運算工作需要原生FP64。
超微於13日確認的CDNA介紹頁將MI430X列為採用CDNA 5架構的產品,並列出當時預計於2027年推出。超微也表示,MI430X與MI455X的支援功能配置可能不同。
Reddit硬體社群8月的討論中,有人肯定288 TFLOPS的效能預估,也有人將超微軟體生態系成熟度與系統成本視為變數。這些是社群反應,不能代表整體產業評價。
歐洲高效能運算共同事業(EuroHPC JU)於2026年8月簽署LUMI-AI合約。該機構在合約公告時表示,計畫於2027年安裝採用MI430X與第6代EPYC處理器的系統,並提供使用者使用。
EuroHPC JU於2025年11月公布的法國Alice Recoque超級電腦計畫,也納入MI430X。
超微先前也公布以8張MI355X執行Kimi K3.1 Pro的配置。這次MI430X資訊除了AI執行配置,也涵蓋科學運算所需的FP64效能與伺服器連接方式。
超微於13日確認的技術部落格表示,將在SC26公布FP64測試方法、資料與結果。SC26預定於15日至20日在美國芝加哥舉行。

Comment 0