

 News
 Coin Information
 About us


 Add as a preferred source on Google
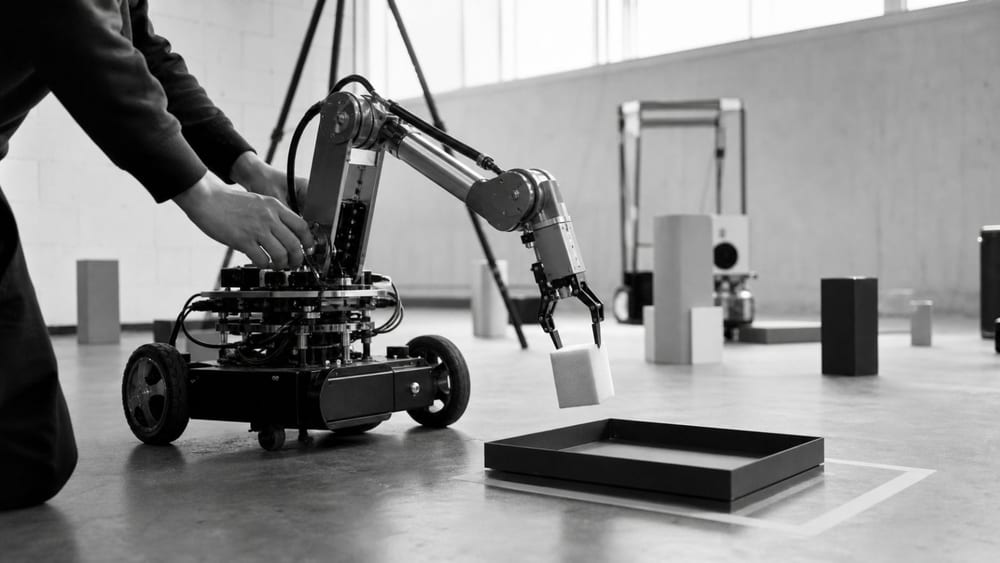
蘋果(Apple,AAPL)研究團隊開發的 HALO 人形機器人自主控制系統,在6處未預先掃描或建圖的室內環境完成360次單項任務,平均成功率達91%;由三種動作組成的連續任務,平均成功率為70%。
研究團隊於4日在 arXiv 預先公開論文,說明 HALO 的系統設計與測試結果。實測使用加裝相機與運算裝置的宇樹科技(Unitree)G1。測試空間並未用於訓練,也沒有事先掃描或建圖。
這項研究著眼於訓練資料不足的問題。若要把口頭指令與相機影像轉化為全身動作,需要三者相互配對的資料;但由人直接操控機器人或拍攝動作,耗時也費力。研究團隊在1000個虛擬室內環境中,建立了300小時的影像、語言與動作配對訓練資料。
為縮小真實與虛擬環境的視覺差異,團隊調整照明色溫、曝光與對比,也加入影像模糊和感測器雜訊,並在虛擬環境中模擬接近機器人相機的視野。
HALO 分為三個階段:先將自然語言指令拆解為細部任務,再依相機畫面規劃未來5秒的全身動作,最後根據深度影像與關節狀態控制動作。系統約每2秒選擇一次任務,動作生成器每秒建立約3次新計畫,控制器則每秒更新50次關節指令。整套系統在機器人搭載的運算裝置上執行。
單項任務包括△移動到指定物體旁△坐上椅子△穿過半開的門△彎身通過低矮障礙物△爬行△推箱子。每項任務都在6處真實環境各測試10次;彎身通過障礙物的成功率為100%,推箱子的成功率為88%。
連續任務在一處真實環境中進行,每種動作組合測試10次。「穿過門後移動到物體旁」10次全數成功;「彎身後坐下」成功率為60%;「彎身後移動到目標物並推箱子」成功率為50%。最後一種組合的5次失敗中,有3次是機器人彎身後把頭轉向箱子的反方向,導致箱子離開視野。
研究團隊製作訓練資料時使用250張 H100 GPU,耗時約48小時;訓練動作生成器使用64張 B200 GPU,訓練動作追蹤器則使用4張 H100 GPU。
資料生成流程雖已自動化,但新增動作時,指令與關鍵姿勢仍須由人設計;動作追蹤器訓練也使用了人類動作影片與動作捕捉資料。研究團隊指出,物體離開相機視野或遭到遮擋時,系統難以判斷接觸狀態,因此將加入觸覺感測列為後續改進方向。

Comment 0