

 News
 Coin Information
 About us


 Add as a preferred source on Google
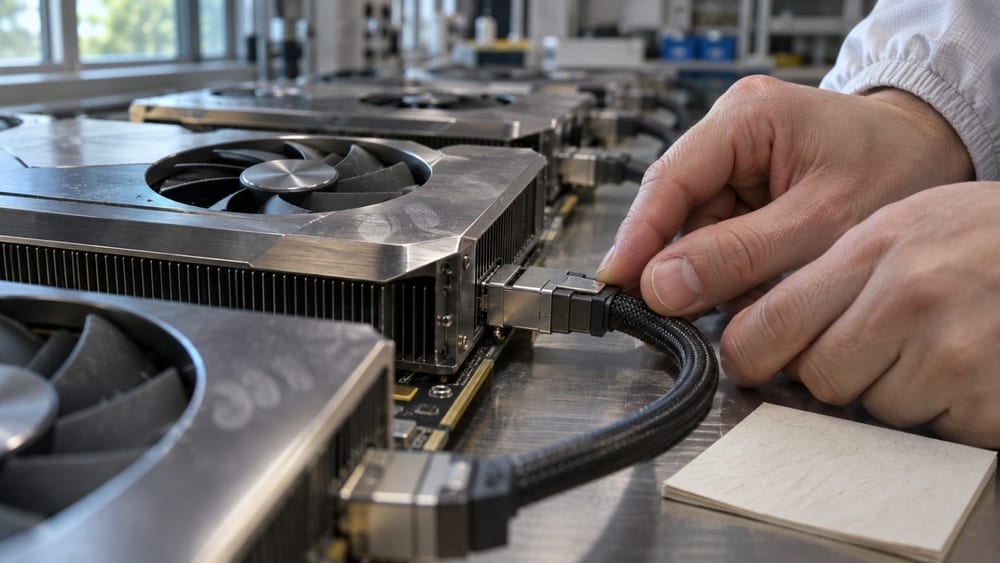
PyTorch 2.15於10月28日發布,分散式訓練預設使用的NCCL通訊後端改為重寫版本。若通訊運算停滯或逾時,系統也會記錄診斷狀態,提供名為「飛行記錄器」的功能。
Crypto Briefing報導,PyTorch於10月28日發布的2.15版,已將重寫版NCCL後端設為所有nccl程序群組的預設值。
使用多個GPU訓練人工智慧模型時,各GPU會分工處理,並交換資料以同步結果。這類通訊會影響整體分散式訓練的進度。
輝達(NVIDIA,$NVDA)的集體通訊函式庫NCCL負責GPU之間的資料交換。需要多個裝置共同參與的通訊運算稱為「集體通訊(collective)」。
新後端預設套用於PyTorch所有nccl程序群組。程序群組是共同執行特定工作的GPU集合。
通訊停滯時往往難以找出原因。即使程序仍在執行,只要集體通訊沒有進展,工作就可能卡住,而且未必會留下像崩潰那樣明確的錯誤訊息。
PyTorch稱為「飛行記錄器(flight recorder)」的功能,會在集體通訊停滯或逾時時自動記錄診斷狀態。維運團隊可檢視紀錄,分析通訊在哪個環節受阻。
這項記錄功能不受特定通訊函式庫限制,因此使用輝達以外硬體或混合環境的團隊也能採用。
新版NCCL後端先在2.14版以選用功能提供;到了2.15版則改為預設路徑,並加入用於診斷集體通訊故障的飛行記錄器。
PyTorch也新增故障後更快重建訓練叢集的路徑,可縮短重新組建通訊群組所需時間。
使用快速重建路徑需要NCCL 2.29以上版本。ROCm環境則由RCCL 2.30.7支援故障後重建。
診斷記錄與工作重建是兩項獨立功能。因此,安裝PyTorch 2.15本身不會讓停滯的訓練工作自動恢復。
本刊先前也曾報導超微(AMD)與Meta在PyTorch中最佳化AMD GPU運算的案例。這次2.15版更新聚焦於多GPU通訊故障診斷及重建流程,與運算最佳化不同。
2.15版仍提供切回舊行為的設定,但該設定預計在下一個版本移除。維運團隊應在實際工作環境中檢查新後端的初始化與通訊行為,以及所需函式庫版本。


Comment 0