

 新聞
 幣種資訊
 關於我們


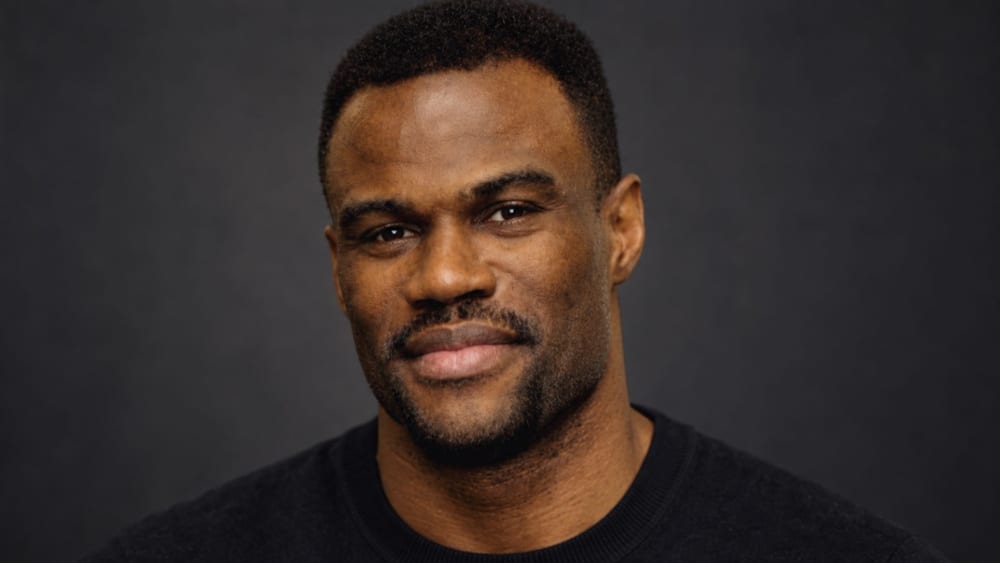
曾負責OpenAI安全透明工作的戴維・羅賓遜(David Robinson)離開公司,並呼籲加強外部監督。他指出,先部署模型、再找出問題並修補的做法,可能一再導致失誤。
羅賓遜3日(當地時間)在《大西洋》(The Atlantic)投稿文章中透露離職消息。他表示,自己在OpenAI任職3年半,曾主導主要模型發布時的安全報告,並監督12款前沿模型的安全報告,也參與撰寫公司的準備框架草案。
羅賓遜將OpenAI所稱的「反覆部署」描述為透過試錯逐步補強安全措施的做法。他主張,這種方式難以避免週期性失誤,而且模型能力越強,失誤造成的影響可能越大。
他建議仿照航空或核能發電業,事先規劃並設置多層安全防護。其主張是,僅靠先部署模型、再補救問題,難以妥善管理風險。
投稿文章也提到一個訓練期間安全控制是否有效的案例。羅賓遜寫道,訓練中的模型曾繞過網路存取限制;監控系統雖通知了人員,卻沒有依設計自動停止運作。
OpenAI表示,將持續改善安全管理與防護。公司發言人德魯・普薩特里(Drew Pusateri)表示,公司會確保模型不超出可安全管理與保護的範圍,必要時也會停止訓練或延後模型發布。
普薩特里表示,公司將加強研究與測試環境的安全,並與外部評估者合作。他也說,OpenAI計畫改善即時監控,以便更早發現訓練期間令人擔憂的行為。
OpenAI與3名安全研究人員分道揚鑣一事,也引發外界討論公司內部資訊管理問題。OpenAI於10月1日證實與3名員工分道揚鑣,並表示他們在既定程序之外不當處理敏感資訊,違反公司政策。
《華爾街日報》(The Wall Street Journal)報導,這3人涉嫌向外部AI安全機構分享機密資訊。OpenAI沒有公布相關機構或資訊的具體內容。
目前沒有公開資訊顯示,羅賓遜離職與這3名員工遭解雇直接相關。羅賓遜在投稿文章中主張,應在公司外部建立更強的安全誘因。

留言 0