

 新聞
 幣種資訊
 關於我們


智譜GLM在由逾10萬張中國製AI晶片組成的叢集上建置GLM-5.3-Flash推理系統,並在不到兩週內將端到端吞吐量提升至初始基準的3倍。智譜GLM於17日透過官方部落格公布上述成果。
智譜GLM表示,基於GLM-5.3的基礎設施代理負責推理基礎設施的設計、協調與最佳化。經過調整後,硬體使用效率與單一代幣成本已達到接近主流NVIDIA GPU的水準。
智譜GLM將此次案例介紹為遞迴式自我改進(RSI)的工程實例,亦即由模型反向改善自身運行系統。

 複製連結
 分享
 列印
 字體大小
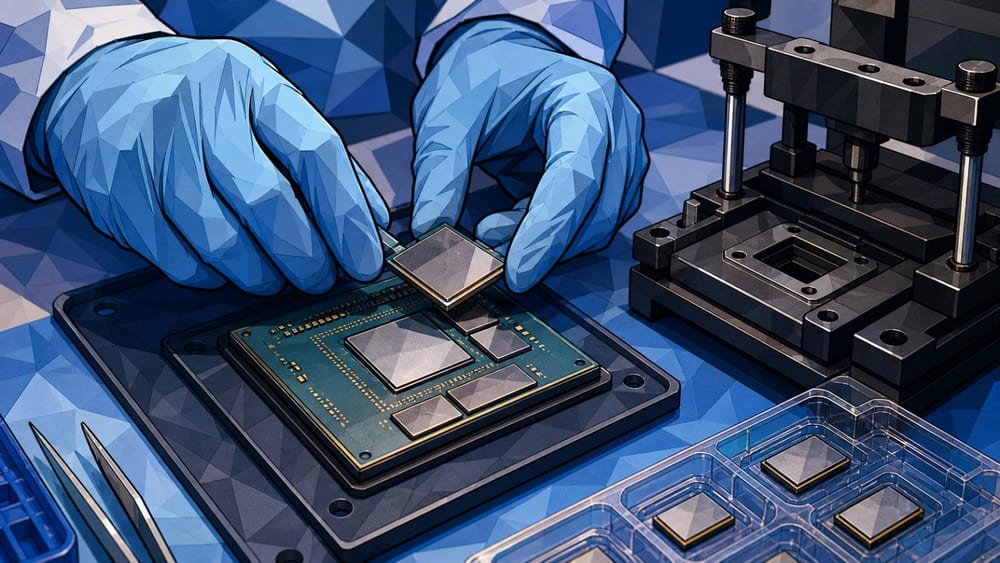
檢查AI加速器板卡的工作人員雙手 / TokenPost.ai
智譜GLM在由逾10萬張中國製AI晶片組成的叢集上建置GLM-5.3-Flash推理系統,並在不到兩週內將端到端吞吐量提升至初始基準的3倍。智譜GLM於17日透過官方部落格公布上述成果。
智譜GLM表示,基於GLM-5.3的基礎設施代理負責推理基礎設施的設計、協調與最佳化。經過調整後,硬體使用效率與單一代幣成本已達到接近主流NVIDIA GPU的水準。
智譜GLM將此次案例介紹為遞迴式自我改進(RSI)的工程實例,亦即由模型反向改善自身運行系統。
<版權所有 ⓒ TokenPost,未經授權禁止轉載與散佈>


留言 0