

 News
 Coin Information
 About us


 Add as a preferred source on Google
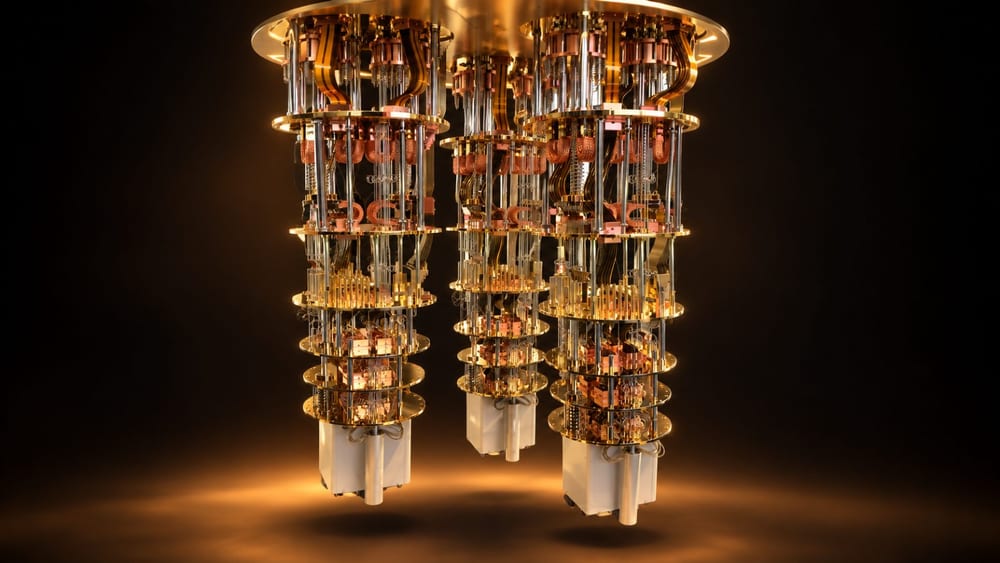
Google量子人工智慧(Google Quantum AI)的超導量子處理器 Willow,以4個量子位元執行Mermin–Peres魔方陣遊戲,勝率達98.30%,高於古典策略理論上限88.89%。
Google量子人工智慧19日在官方研究部落格公布這項實驗,研究論文同日登上《Science》封面。
魔方陣遊戲在3×3格子的每個位置放置+1或−1,是一種合作遊戲。一名參與者負責行,另一名負責列,兩人不能互相通訊便作答。所有各行乘積須為+1、各列乘積須為−1,因此共享預先寫好表格的古典策略,在9種組合中至少會失敗1次,勝率不可能超過88.89%。
研究團隊將9種遊戲組合各執行10萬次,Willow的整體勝率為0.9830±0.0001。Google表示,未能獲勝的主要原因是硬體仍存在雜訊。
研究重點是量測量子測量結果會隨測量脈絡改變的量子脈絡性。量子脈絡性指某個數值可能因同時測量的其他觀測量不同而改變。
研究團隊以Bell–Kochen–Specker不等式量化量子脈絡性。Willow的分數為χ=5.590±0.008,高於古典上限4,但仍未達量子理論最大值6。
Willow透過兩對糾纏量子位元,讓交叉格位的答案以高於古典上限的機率相互一致,直接展示同一裝置在多種測量條件下產生的相關性。
另一項GHZ奇偶遊戲最多使用71個量子位元,其中45個被確認形成單一真正的糾纏狀態。隨量子位元增加,雜訊同步上升,與古典策略的差距縮小,但結果仍高於古典上限。
隱藏線性函數問題最多在105個量子位元上執行,答對機率約0.6,高於0.5;但相同規模的古典比較基準尚未經數學確定。由於該基準依賴研究團隊的估計與推測,單靠這項實驗仍無法確定量子優勢幅度。
Google將魔方陣和GHZ實驗定位為量子處理器性能的固定物理基準測試,而不是證明商用演算法優勢。由於多個量子位元必須同時精準協作,這類測試可揭露隨機電路試驗可能漏掉的細微錯誤。
Google表示,量測結構化電路品質可用於檢查分子與材料模擬所需的量子電路。不過,這次研究並未直接執行化學或材料計算。
The Quantum Insider指出,105量子位元隱藏線性函數實驗的古典比較基準仍依賴推測。The Next Web則報導,論文並未宣稱對所有古典電腦具無條件優勢,也沒有直接執行化學或材料計算。
本報先前曾報導Willow將魔法態生成錯誤率降低約40倍的研究。當時研究同樣不是測試通用計算能力,而是評估在實際量子晶片上降低錯誤、提高硬體可靠度的方法。
這次研究沒有提出比特幣(BTC)或其他區塊鏈加密金鑰破解、加密系統崩潰時間或虛擬資產價格影響。研究焦點是量子脈絡性與硬體錯誤的量測方法。
要評估實用化,仍須降低殘留雜訊,並以數學方式確立105量子位元實驗的古典比較基準。此次研究提出的是同時量測量子脈絡性與硬體錯誤的方法。


Comment 0