

 新聞
 幣種資訊
 關於我們


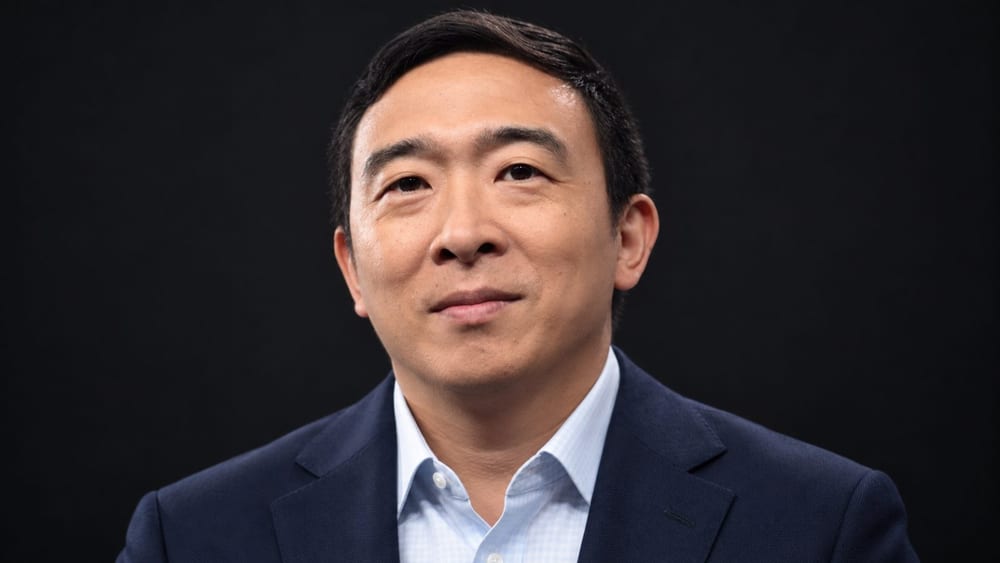
人工智慧(AI)企業若將個人資料與創作內容用於模型訓練,就應向資料提供者與創作者支付報酬的主張再次受到關注。這項提議源於對AI普及可能減少工作、並使資本與資料集中於少數科技企業的擔憂。
安德魯·楊(Andrew Yang)於27日參加Jubilee Media辯論節目《Surrounded》,並與AI樂觀派展開辯論。他主張,AI消除既有工作的速度可能快於創造新工作的速度,進而擴大不平等。安德魯·楊此前也曾提出高效能AI模型需要「停止開關」的主張。
安德魯·楊提出的核心構想是「資料紅利(Data Dividend)」。如果企業使用個人資料與內容訓練AI模型並獲利,就應將部分收益返還給提供資料的使用者與創作者。
安德魯·楊主張,個人資料的商業價值每年超過3000億美元(約406.8兆韓元),但幾乎沒有回到大眾手中。他表示,大型科技企業利用使用者資料開發AI模型並獲利之際,資料提供者卻被排除在報酬之外。
他也分享自己曾因著作被用於AI訓練,透過出版社收到2500美元(約339萬韓元)的案例。他認為,任何內容創作者的作品若被用於AI模型訓練,都應以類似方式獲得報酬,這才符合公平原則。
安德魯·楊也提出AI對勞動市場影響的疑慮。他表示,律師、會計師、資料分析師等中等技能職業可能受到自動化影響,企業可能減少招聘,轉而增加伺服器與資料中心投資。
他指出,資本、資料與運算能力可能因此集中於少數企業,進一步強化「贏家通吃」的結構。即使AI技術提升生產力,相關收益也不會自動分配給勞工或資料提供者。
作為應對方案,安德魯·楊也提出全民基本收入。他構想以資料紅利及對科技企業徵收的稅款作為財源,向民眾提供基本收入;受益者若將收入用於地方消費,則可支撐經濟循環。
在稅制改革方面,他提到引入加值稅的可能性。他認為,僅靠現行公司稅難以阻止跨國科技企業避稅與利潤轉移,因此應在數位服務、廣告點擊與資料交易等產生附加價值的環節課稅。
若要將資料紅利落實為制度,仍須釐清資料價值評估、權利人確認、企業支付方式,以及創作內容可被用於AI訓練的範圍。全民基本收入與加值稅如何連結,也需要就課稅對象與負擔主體展開討論。
這場討論的焦點並非是否停止AI開發,而是技術進步創造的收益應由誰取得。資料所有權、報酬標準與科技企業課稅方式,仍是制度設計過程中有待討論的議題。



留言 0