

 新聞
 幣種資訊
 關於我們


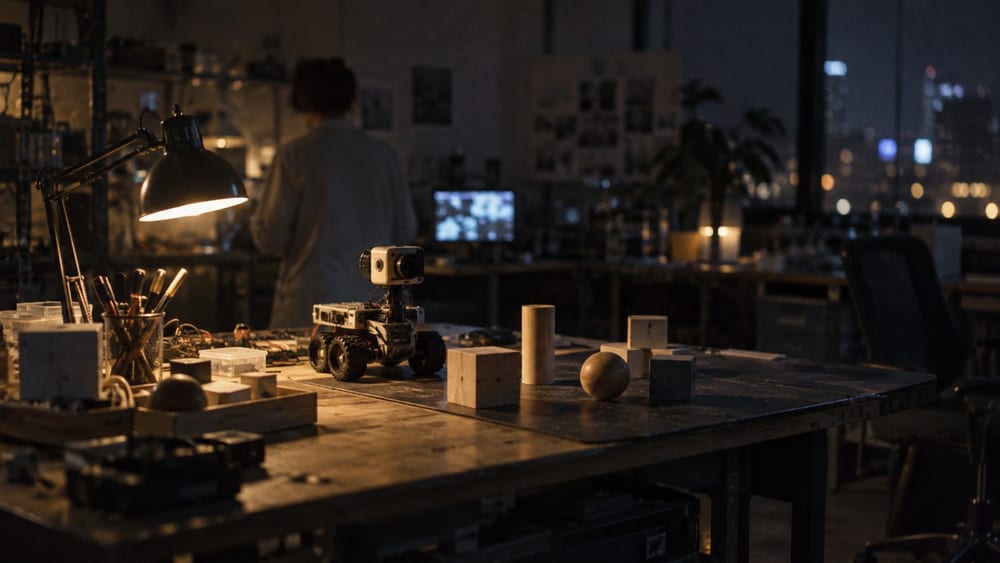
由Google DeepMind與哈佛大學研究人員參與的21位學者,共同發布一份白皮書,將視覺經驗視為通用人工智慧(AGI)研究的核心路徑之一。白皮書並未指定任何具體模型,也沒有預測AGI實現的時間點。
以片岡裕雄(Hirokatsu Kataoka)為首的研究團隊於8月26日發布《Visual General Intelligence: A White Paper》,作者名單中包括Google DeepMind研究員羅伯特‧蓋爾霍斯(Robert Geirhos),以及哈佛大學研究員杜逸倫(Yilun Du)。
白皮書提出的「視覺通用智慧」(VGI)並非指單一模型或架構,而是一個研究方向:讓系統透過影像、影片與幾何資料,學習預測、生成、復原、空間理解與行動能力。
研究團隊提出的問題是,過去以語言為核心的AGI研究,透過文字預測擴展出一般化能力,那麼視覺資料是否也能孕育出類似的智慧。研究團隊指出,視覺資訊中包含物體形狀、空間關係、運動與物理結構等語言難以明確表達的內容。
白皮書並未把視覺智慧局限在影像辨識,還把未來情境預測、隱藏結構復原、三維空間表示,以及在新環境中持續學習等課題,都納入研究範圍。
白皮書也討論了機器人觀察周遭環境後採取行動、再把結果回饋到學習中的「具身智慧」與主動感知。這代表研究範圍已從單純的視覺分類,擴大到與真實環境的互動。
研究團隊並非主張捨棄語言。白皮書強調以視覺為核心,同時結合語言、聽覺、觸覺與本體感覺的多模態研究方向。
羅伯特‧蓋爾霍斯(Robert Geirhos)在白皮書中寫道:「生成式影片模型將成為視覺基礎模型。」這代表的研究觀點是,生成式影片模型有可能從只執行單一任務的工具,發展成可處理多種視覺任務的基礎模型。
不過這項說法並未代表已獲驗證的產品性能,也不代表業界已有共識。白皮書並未提出生成式影片模型的具體性能數據,也沒有公布產品上市計畫。
白皮書同時說明,VGI的定義、評測基準、學習方式,以及視覺與語言之間的關係,目前都還沒有統一結論,也沒有提出僅憑視覺經驗即可實現AGI的實證結果。
這場討論源自2026年6月舉行的CVPR 2026 VGI工作坊。CVPR官方議程中列有「Visual General Intelligence」工作坊,Google Research的活動說明中也記載了蓋爾霍斯主講的VGI場次。
Google DeepMind先前已提出評估AGI性能、通用性與自主性的分類架構,並討論從AGI邁向超級智慧的路徑。Google DeepMind的AGI研究也曾引發性能、通用性與自主性判準的爭論。
這份新白皮書把上述研究脈絡延伸到視覺經驗與物理世界理解的層面,可能與生成式影片、空間人工智慧、機器人學習與世界模型研究產生連結,但白皮書並未提出具體的商業化時程。
此前Google DeepMind也曾討論,AGI之後邁向超級智慧的路徑中,遞迴式自我改進的可能性。AGI之後遞迴式自我改進的可能性,也曾成為業界研究與投資討論的話題。
目前VGI還不是成熟的技術或產品,而是一項探索視覺學習能否通往通用智慧的研究議程。白皮書中沒有涉及模型上市時程、AGI實現時間點,或性能優劣的相關內容。

留言 0